
告别真机数据 “锚点”:深朴智能开源 HiFi-UMI,实现无本体数据直达真机部署!
具身智能要规模化落地,卡点越来越集中在数据上。机器人操作数据目前主要有两个来源:真机遥操作足够准确,但要占用机器人、操作员和固定场地,成本高、扩不动;UMI 这类无本体采集轻巧便携,能直接进真实场景,规模化容易得多 —— 但行业普遍只把它用在预训练阶段。到了学习具体任务的后训练阶段,仍然要掺入一定比例的真机遥操作数据作为“锚点”,用来对齐机器人本体、执行时延和真实环境差异。
核心问题在于:与其不断压缩真机数据的占比,能不能反过来 —— 提升无本体数据的保真度,彻底摆脱对真机遥操作“锚点”的依赖?
深朴智能给出的答案是 HiFi-UMI,一套便携式 UMI 数据生产系统。它的硬件和软件围绕四件事协同设计:轨迹精度、双手相对位姿、时间同步、视野覆盖,分别对应头戴式离线双目惯性 SLAM、原生而非事后重建的相对位姿、共用一路微秒级 GPIO 触发,以及每只手两枚超广角相机。
这套设计在工作空间内达到 3 mm 的末端精度,且无需依赖任何外部定位设备。后训练只用 HiFi-UMI 示教,策略可以直接部署到真机。
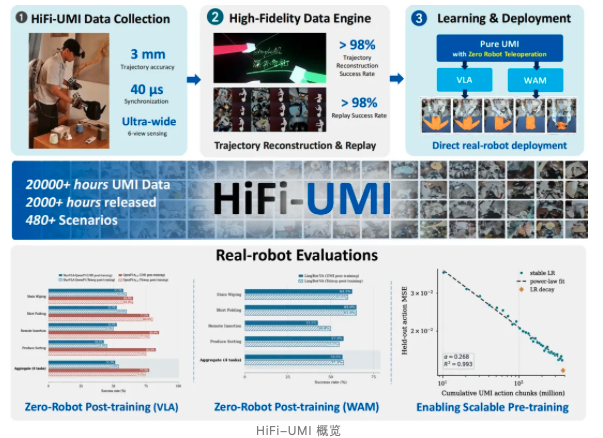
HiFi-UMI 概览
毫米级精度,微秒级时序对齐
构建部署级采集底座
传统UMI设备通常依赖腕部相机进行视觉定位,长程轨迹可能产生漂移;单一腕部视角也容易形成盲区,双手相对位置若依赖事后重建,再叠加多路传感器对时误差,还可能进一步放大动作偏移。
HiFi-UMI将视觉定位的核心视角从高速运动、频繁遮挡的手腕转移至更加稳定的头部,采用头戴式双目相机与惯性测量单元(IMU),通过离线双目惯性 SLAM 重建头部轨迹。左右手分别安装视觉标记结构,由头部双目相机在统一坐标系中同步定位,无需事后拼接即可获得稳定、原生一致的双手相对位姿。
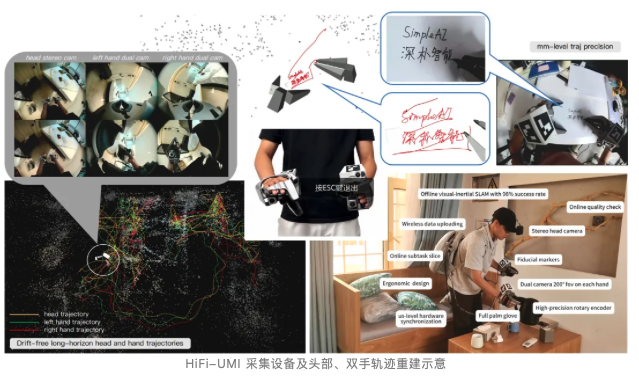
HiFi-UMI 采集设备及头部、双手轨迹重建示意
在提升轨迹精度的同时,HiFi-UMI在每只手部配置上下两枚超广角鱼眼相机,加上头部双目形成 6 路视觉,单腕水平视场角约 200°,垂直视场角超过 200°。头部视角负责提供更加稳定、完整的全局观察,腕部视角则近距离记录夹爪、物体与操作区域的交互细节,形成“全局定位与观察—局部操作感知”相互补充的视觉配置。即使目标物体在某一路画面中受到遮挡,系统也可以结合其他视角识别操作对象、判断任务进度并定位动作边界,为后续轨迹重建、质量检查与AI辅助标注提供更完整的信息。
在手写轨迹实验中,HiFi-UMI能够清晰重建毫米级笔尖运动,末端轨迹误差近约为 3毫米,全程不依赖任何外部定位设备。这种头腕多视角协同设计,在保持设备便携性的同时,提高了长程轨迹的稳定性、双手协同定位精度及操作过程的可观测性,为衣物折叠、物品整理、双手搬运和精细插入等任务提供更加可靠的数据基础。
书写任务实测轨迹精度,通过六个同步相机视角重建3D轨迹
HiFi-UMI使用统一的GPIO硬件触发器,同步驱动全部相机、惯性测量单元和夹爪编码器,相机、IMU 与夹爪编码器由同一 GPIO 硬件信号触发,将跨传感器时间偏差控制在40微秒( 0.00004 秒)以内。全掌手套式夹爪兼顾精细操作与较大物体抓取,让示教动作更接近自然接触和发力方式。
在长距离任务中实现高精度的无漂移轨迹重建
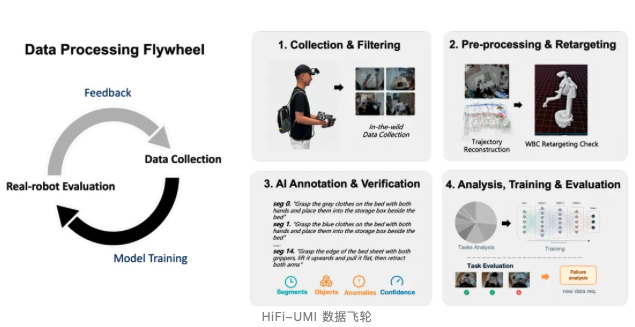
采集完成后,数据依次经过轨迹重建与清洗、仿真重定向、AI 辅助标注、人工复核和统计导出。轨迹重建与仿真回放的通过率均约为 98%,两道关卡串联后,原始采集数据的基础有效率约为 96%。每段有效示范均保留同步多视角视频、双手轨迹、夹爪状态、语言标注和质量记录,可按任务、场景和动作类型进行筛选与追溯。
零真机后训练
跨两类模型家族均接近遥操作
真正的考验还是在于机器人能否把任务做完。
团队设置了严格的场景条件:真机遥操作数据直接采自评测环境,而 HiFi-UMI 示范来自不同地点、背景和光照,没有一条是在评测现场采集。真机测评选取四项双臂任务——污渍擦拭、衬衫折叠、遥控器插入和果蔬分类,覆盖持续接触、柔性物体操作、精密放置和语义分类等能力。实验分别在 StarVLA-QwenPI、OpenPI-π0.5 和 LingBot-VA 三种模型上进行,同一模型内仅更换后训练数据来源。其中前两者属于视觉-语言-动作(VLA)家族,LingBot-VA 属于世界-动作模型(WAM)家族。
结果显示,仅使用 HiFi-UMI 数据后训练的策略,与使用评测现场真机遥操作数据后训练的策略表现相当。三种模型的整体成功率差值分别为 -2.5、+3.1 和 -0.6 个百分点,均处于评测采样波动范围内;其中,HiFi-UMI 后训练的 OpenPI-π0.5 在遥控器插入任务上成功率高达85% 。旗鼓相当的还不只是成功率:单独测位姿解码精度,UMI 后训练模型在真机观测与 UMI 观测之间的差距仅 3 毫米和 0.2 度,而随机动作的平移误差接近它的五倍。
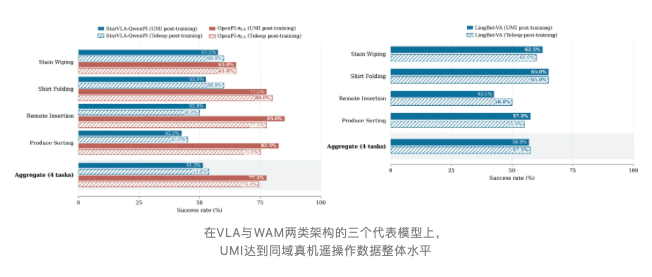
在VLA与WAM两类架构的三个代表模型上,
UMI达到同域真机遥操作数据整体水平
4000 小时预训练,动作误差降低41%
真机成功率再涨18.1个百分点
除替代真机后训练数据外,HiFi-UMI 还能作为大规模预训练数据。团队使用 4,000 小时多任务数据预训练 StarVLA-QwenPI,在十个未训练过的任务上,平均动作预测误差下降 41%;随后使用相同的 HiFi-UMI 数据进行后训练,四项任务的整体真机成功率由 51.3% 提升至 69.4%,增加 18.1 个百分点。训练过程本身也是可量化的:一遍语料内留出动作预测误差下降 61%,且随累计训练量严格遵循幂律(α = 0.268,R² = 0.993)。
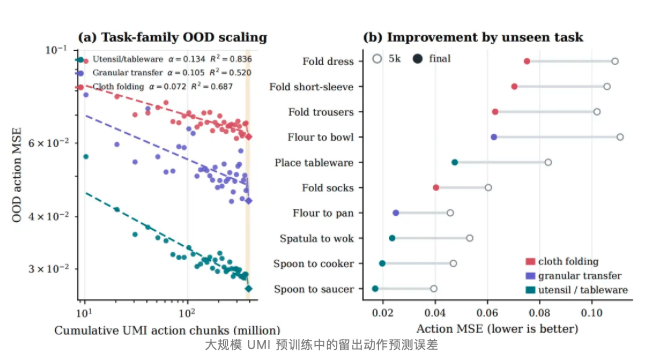
大规模 UMI 预训练中的留出动作预测误差
那么一个任务需要多少数据?仍以遥控器插入为例:400 条时成功率 37.5%,800 条升到 65%,1,600 条 70%,3,200 条 85%,而继续加到 6,400 条不再提升,单任务的收益集中在前几千条。
在遥控器插入任务上,经过预训练的模型仅使用 800 条专项数据,就超过了未经过预训练、使用 3200 条数据的版本。把十个未见任务按族拆开看,餐具器皿类提升最快、颗粒转移居中、衣物折叠最慢,这个排序几乎完全对应预训练语料的构成:物体放置类动作占语料帧数三分之一以上,而织物折叠不到 1%。实验表明,模型能否迁移到新任务,主要取决于预训练数据是否覆盖相似的抓取、对齐、插入等交互过程,而非是否见过同一件物体。
开源,释放2000小时HiFi-UMI-2K 数据
HiFi-UMI的价值覆盖了机器人学习的两个关键阶段:在预训练阶段,大规模、多任务数据帮助模型积累可复用的视觉—动作经验;在后训练阶段,高精度任务示教帮助模型快速掌握具体操作,并直接部署到真实机器人。随着数据规模持续扩大,模型可以接触更多物体、场景、动作路径和失败恢复过程,逐步形成从数据增长到能力提升、再到真实部署的完整循环。
HiFi-UMI 数据飞轮
目前,HiFi-UMI 数据生产体系已处理超过 2 万小时、432 万段操作数据,覆盖 480 余个场景。此次开放的 HiFi-UMI-2K 是其中经过质量筛选与分布平衡的 2,000 小时子集,包含六路微秒级同步视频、标定后的双手轨迹、夹爪状态、语言描述和子任务边界。数据以 LeRobot v3 风格格式发布,采用 CC BY 4.0 协议,允许学术研究和商业使用。
HiFi-UMI 数据星图
从高保真采集、自动化质量治理,到预训练、后训练与真机部署,HiFi-UMI 打通了一条不依赖真机遥操作数据的完整链路。深朴智能希望通过开放数据与技术成果,推动更多团队共同验证无本体数据的规模化价值,加快具身智能从数据增长走向真实部署。
论文信息
- 论文题目:HiFi-UMI: Learning Deployable Manipulation Policies from High-Fidelity UMI Data Alone
- 论文地址:https://arxiv.org/abs/2607.25895
- 项目主页:https://cloud.simpleai.tech/simple-world-lab/hifi-umi/
- 开源数据集:https://huggingface.co/datasets/simple-world-lab/HiFi-UMI-2K